文 / 文勇刚
翻译/ 李易扬
校对/ 周蓬岸
本演讲是第十届网络社会年会新加坡场、暨新加坡管理大学(SMU)Web3Week(11月27日至30日)的特别策划活动“将临的网络:互为劳动与社会的重组”(The Network to Come: Inter-Labor and the Recomposition of the Social)活动中“将临的网络”(The Network to Come)系列主题演讲之一,本文现场录音整理并翻译。
主持人朱飞达教授:
我们非常荣幸地邀请到文勇刚教授作为我们的第一位主题演讲嘉宾。文勇刚教授和我是多年的老朋友,在新加坡,如果你和任何人谈起区块链和Web3,文教授绝对是这个领域的领军人物,尤其是在南洋理工大学(NTU)发起了很多相关的项目。
我们一直以来都在研究一些有趣的话题,所以非常感谢勇刚教授对我们活动的支持。他非常忙碌,但还是抽出时间参加了今天的活动。正如大家所见,他将要谈论一个非常有趣的话题:人工智能和区块链的全新统一框架。让我们欢迎文教授!
文勇刚博士:
各位早上好!谢谢飞达的介绍。非常荣幸来到这里,在“当AI遇见区块链”的主题上,分享一些我最近的思考——当AI遇上区块链。实际上,该想法已在我脑海中萦绕了数年之久,两年前,当维塔利克(Vitalik Buterin)来到南洋理工大学演讲时,现场听众就向他抛出了这个问题:“如何看待AI与区块链之间的交互?”当时,维塔利克给出了一些直观的想法,但后来,越是琢磨这个问题,我就越觉得它极具研究价值,并机缘巧合之下开始了思考:如何依托自己的研究背景,为“AI与区块链交互”这一充满潜力的话题贡献新见解?
实际上,驱使我探索这一话题的首要动机,是人类的天性——我们总在为万物寻找一套统一理论,试图将万物归一。纵观现代物理学史,科学家们辨认出了四种基本力[1],在这之后,一个十分自然的问题产生了:是否存在某种可能,将这四种力统一到一个理论中?沿着这条思路,人们提出了各种不同的观点与构想,力图实现整合的目的。
首先是爱因斯坦,他在1912年提出了统一场论,试图将引力与电磁力统一起来;到了1947年,大统一理论应运而生,旨在将强核力、弱核力与电磁力融为一体。可以说,问题的终极目标,就是找到这个能统一全部四种力的理论。迄今为止,只有弦理论被认为与目标相符,但它尚未被证实或证伪,无法确认其是否为问题的最终答案,或终极解决方案。事实上,这也促使我去思考:能否建立某种统一的理论或框架,来搭建AI与区块链之间的桥梁?
另一个吸引我关注该问题的有趣发现是,去年年底,我在社交媒体上看到了这篇帖子及配图(比特币与英伟达10年投资回报)。目前,作为区块链领域的从业者,人们对投资回报问题确实极为谨慎和敏感。因此,我请自己的学生做了这项工作——我们试图计算这样一种投资收益情况:假设在2014年12月5日当天,你投入一万美元,去购买英伟达的股票或比特币,最后的投资回报会是多少呢?结果显示,英伟达股票的投资回报率达到了275倍,而比特币则为274倍。
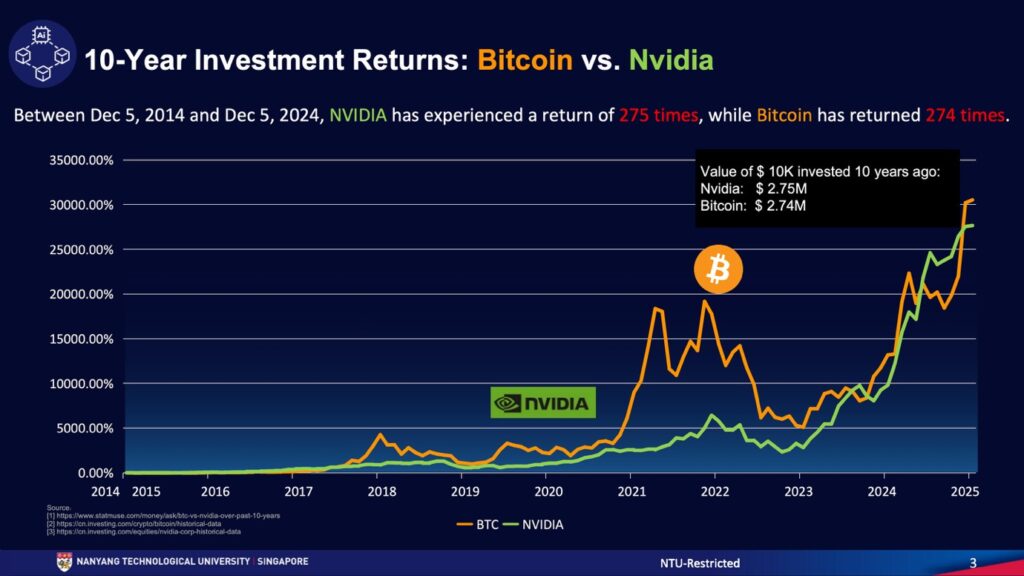
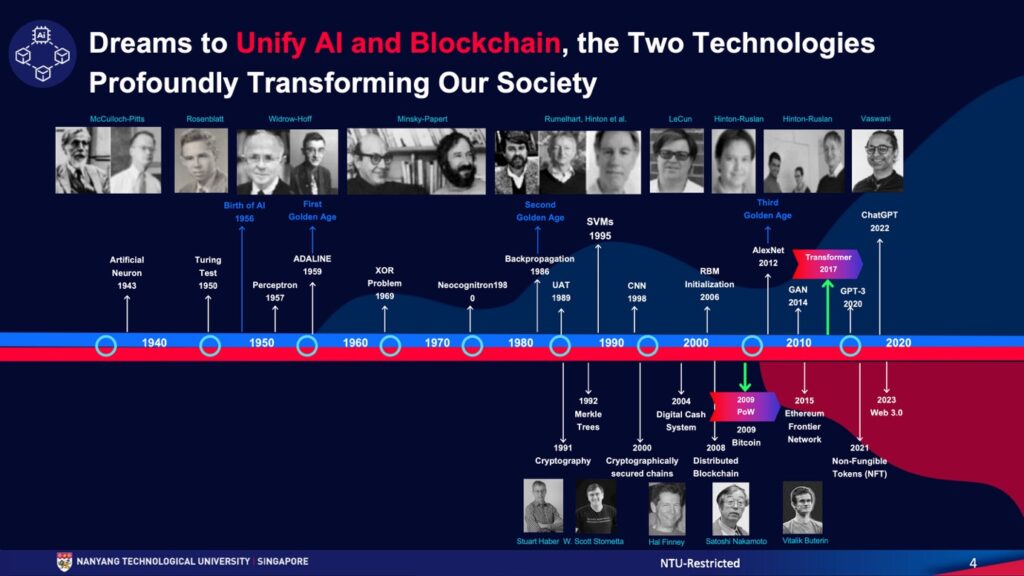
这一数据截止至去年十二月,而非当下,因为目前的比特币价格已跌至八万美元左右。这就引出了另一个有趣的问题:为何这两种投资工具在十年间能产生如此相近的回报,它们之间是否可能存在某种内在关联?其原因是,在理论或观察的背后存在着某种规律——当我们探究AI与区块链,观察它们的技术演进时便会发现这一点。这些年来,人们也持续研发各类技术,来推动这两大领域的协同发展。
因此,我向自己提出的问题是:是否存在某种理论或框架,能让我们在AI与区块链之间搭起桥梁?这正是我试图解答、反复思考的问题。如各位所知,在当前ChatGPT、DeepSeek等应用普及的背景下,我首先想到的便是向它们寻求答案。遗憾的是,它们的回应都没能满足我的好奇心。
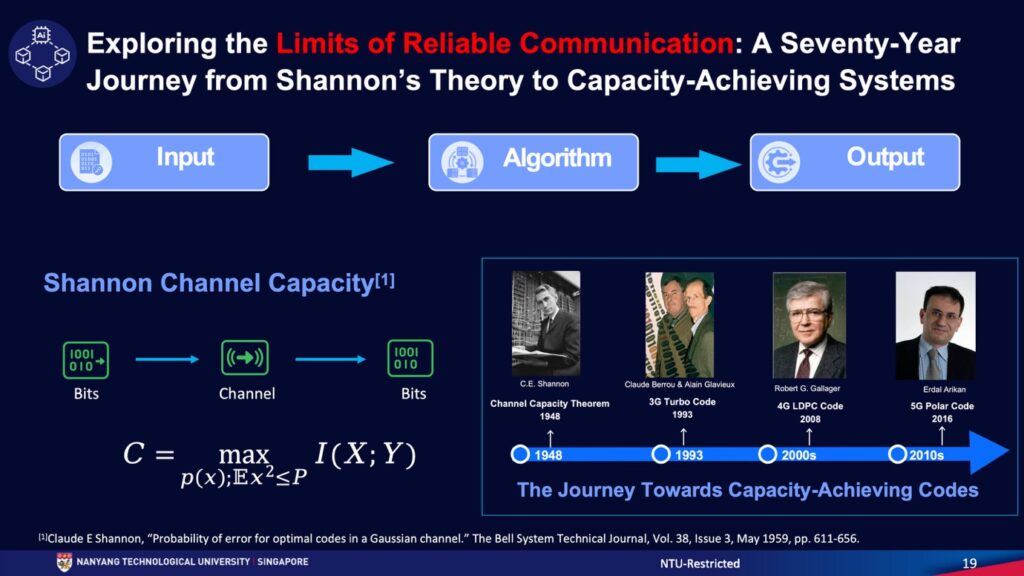
于是,我决定回归自己的学术起点。最初,我作为一名电气工程领域的研究者开启了学术历程,专注于信息论方向。在座各位有谁了解信息论吗?这是一门研究信息如何在不同信道中传输的学科。当时我想,能用信息论来分析上面的问题吗?没想到,这个思路真的给了我一些启发。
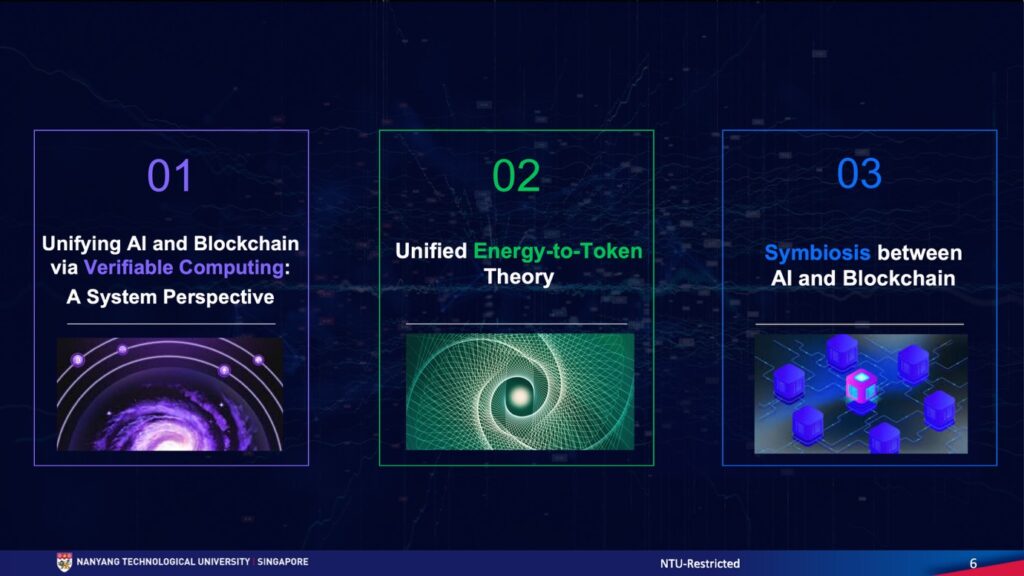
接下来切入正题,今天我的演讲将分为三个部分。首先,我会尝试提出一个观点 ——将可验证计算(verifiable computing)作为连接AI与区块链的桥梁。基于这一框架,我们接下来会探讨能源代币化理论(energy to token theory),以及AI与区块链之间的共生(symbiosis)关系。
下面,我将从一个有望打通AI与区块链的可能框架讲起。如今,当你听到“AI”,脑海中浮现的第一个词是什么?有没有听众愿意试着回答一下,在座的朋友里有计算机科学家吗?
人们常说:“我要用这么多词元(token)来完成这项工作”,事实上,当AI被提及时,首先进入到我想法中的词就是token。大家不妨回想一下,在十年前比特币的工作量证明机制中,人们也使用了同一个词,即“代币”(token)本身。
区块链中的工作量证明(POW)共识机制,本质上是通过“挖矿”生成下一区块的过程,这个过程同样会生成代币。具体来说,对那些稍有区块链技术背景的人而言,“挖矿”就是尝试在区块头中找到一个随机数(nonce),使得对应的 SHA-256 哈希算法输出结果小于目标阈值。这正是挖矿所要完成的任务。它意味着,你要做的就是在一个熵值极高的空间中,找到符合条件的特定子集。从信息论的角度来看,这个过程会让系统的熵值大幅降低。在计算机科学领域,该操作被称为“可验证计算”。
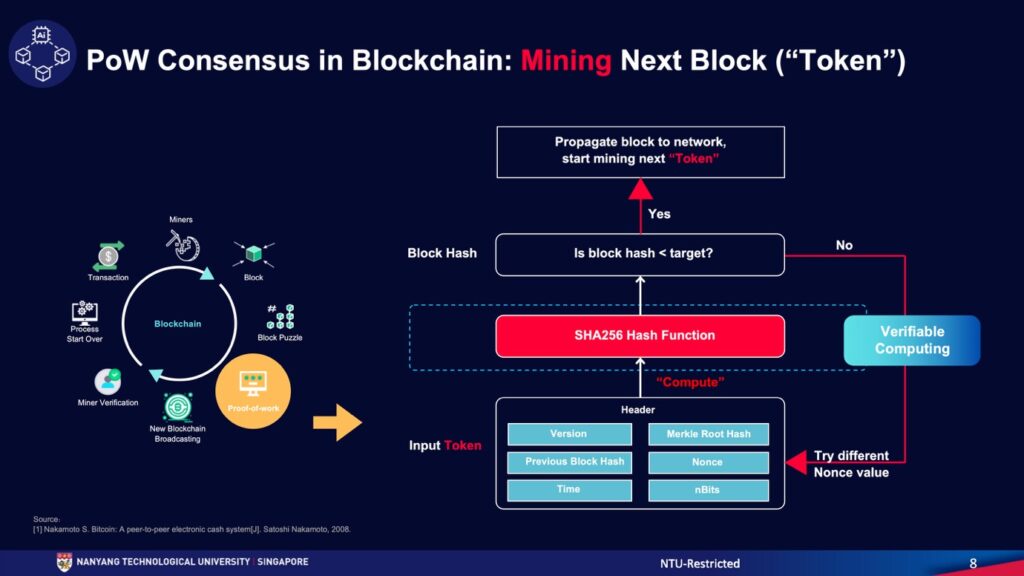
现在让我们回到最新的大语言模型领域。想必大家都知道,AI界有一个著名的说法:“注意力就是一切”(Attention is all you need)。而实际上,如今人们常说的则是:“预测下一个词元(token)就是一切”。
注意力机制的核心,正是通过 Transformer 解码器来预测下一个词元。在区块链(或POW)中,核心是预测下一个区块的有效生成条件;在大语言模型中,核心则是预测下一个词元的具体内容。两者的逻辑看起来高度相似,对吧?正是由于算力的存在,我们才能预测下一个词元。 (不论是哪一种预测),二者都试图在一个极其庞大的搜索空间中,找到一个低熵子集。
最近,另一个问题被提了出来:此类大语言模型的推理过程是否能够被验证?这是面对大语言模型时,人们开始关注的另一个重要议题。
实际上,如果我们将AI(或大语言模型)与区块链(或加密挖矿)置于相同语境中,就会发现,二者在本质上指向同一个目标:生成“词元/代币”(token)——不论你试图预测作为代币的下一个区块,还是想通过加密挖矿生成下一个代币,这些举动都是围绕 token 展开的。其过程也都涉及一个中间环节,它或是通过计算哈希值来执行,或是借助Transformer模型来执行,这些方式本质上都属于某种形式的可验证计算。
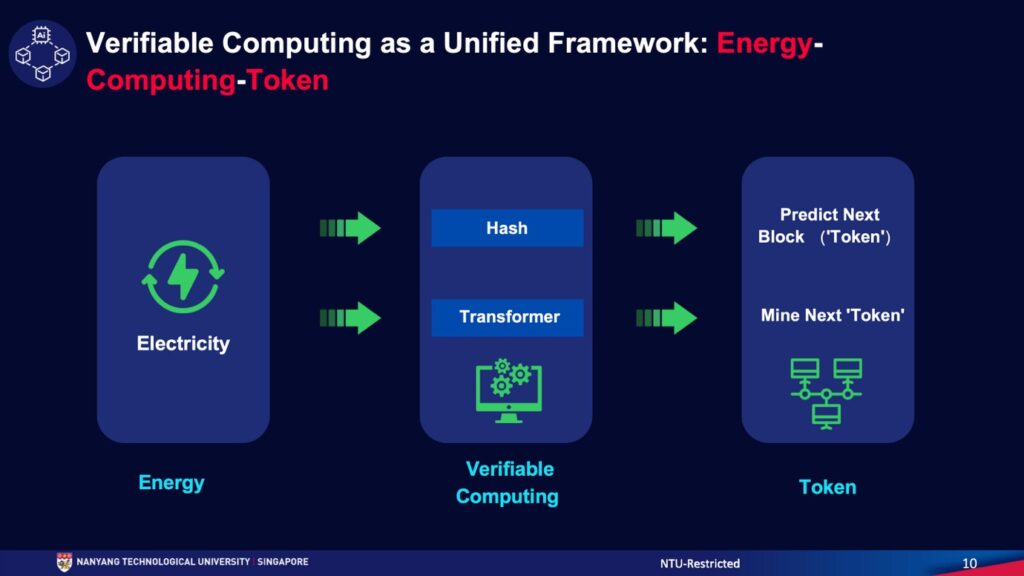
上述系统的输入是什么呢?答案就是电力。也许听过我其他关于可持续AI演讲的观众知道:加密货币挖矿和AI,是目前全球耗电量最大的两个领域,它们消耗着极其庞大的能源。因此,巧合的是,这两大应用都消耗着巨量能源 。以上内容是对两个系统的初步理解,让我们尝试一下,看看能否从这两点观察中得出新的成果。
首先是AI或大语言模型:在AI推理过程中,我们使用算力、消耗能源,将这些高熵的提示词转化为低熵的词元。这正是该过程的核心逻辑。在区块链代币挖矿过程中,相似的流程也存在着。我们面对着一个高熵的随机数空间,需要从中寻找的并非真正意义上的唯一解,而是首个可用解。这一目标正是通过算力来实现的。
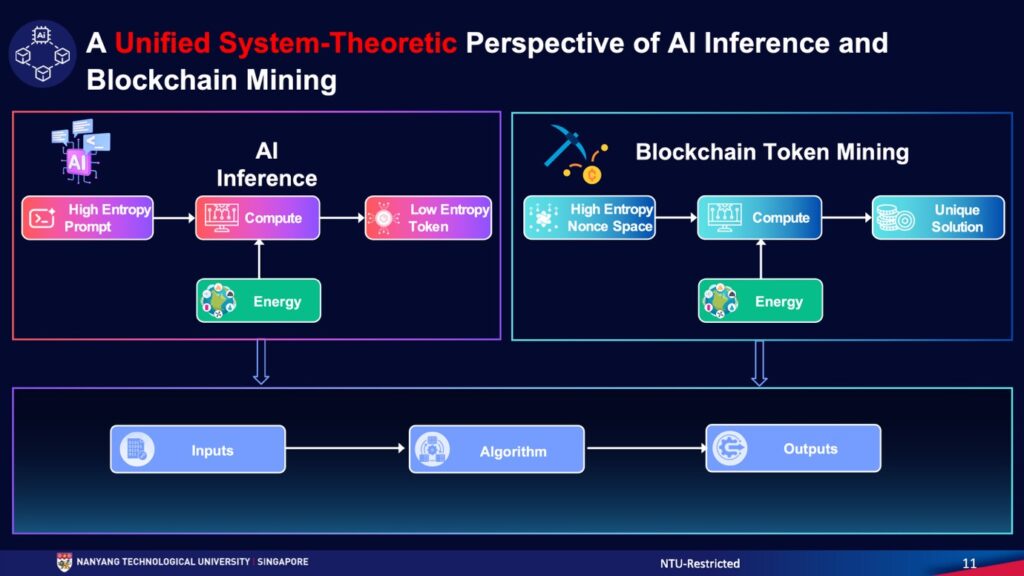
这同样是一个熵减过程。因此,从这一点上看,以上两者具有相同的结构——我正是通过结构相似性来对比这两个系统的:它们都包含输入、输出两个环节,中间则是某种用于信息处理的算法。实际上,这正是我们在通信系统或通信理论里持续研究的重点。
于是,我开始追溯自己本科时所接受的电气工程专业训练,以及博士阶段专研信息论的学术历程。我们可以沿着这个思路往下探索,接下来的问题是:该发现对我而言意味着什么,它能否为本次演讲的中心问题带来新启发?于是,我们开始深入思考这一可能性 ,这也是我会向 ChatGPT 请教的地方:让它谈谈这个思路是否成立、能给我带来怎样的洞见。
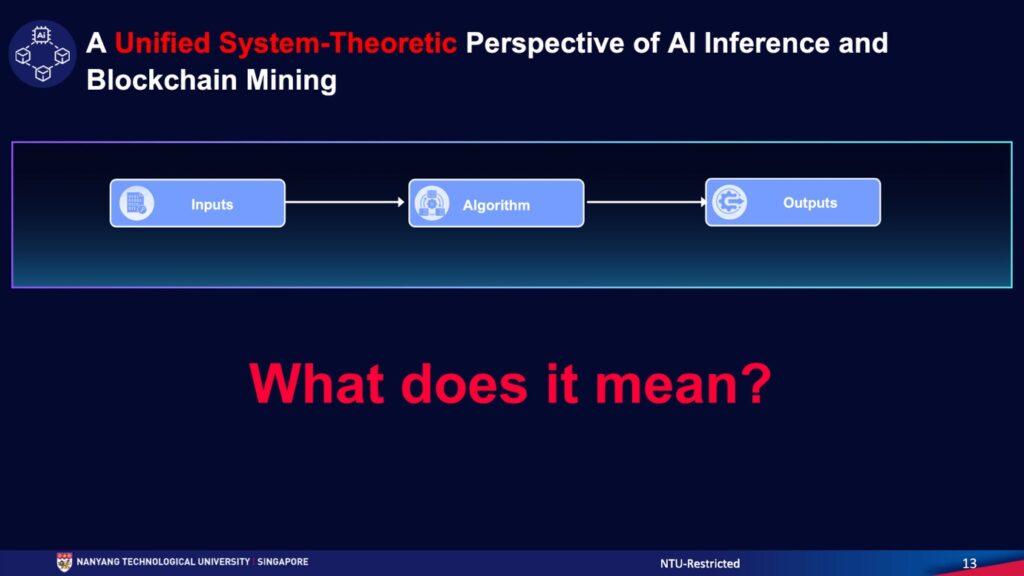
再强调一下,请记住,核心框架始终是:输入、算法、输出这三个环节。那么,这对我的研究有何启示呢?我将这个问题抛给了 ChatGPT,向它询问:“针对这个思路,我该了解些什么?”GPT给出的第一个答案是:在基础物理学中,存在一个名为兰道尔原理(Landauer’s principle) 的定律。
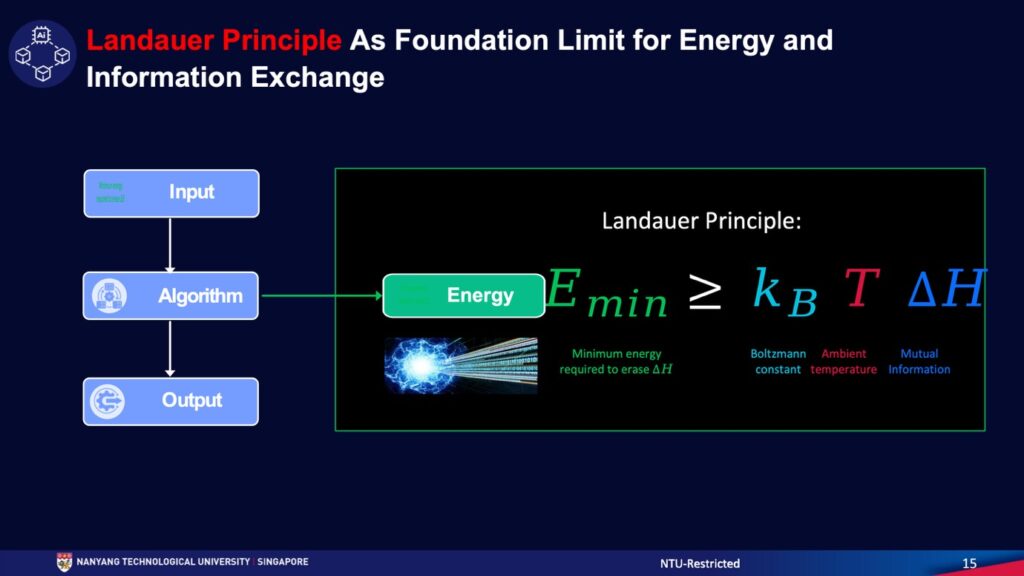
我不确定大家是否了解兰道尔原理。兰道尔是 20 世纪 60 年代 IBM 的一名研究员,他于 1961 年在《IBM 研究与开发期刊》(IBM Journal of Research and Development)上发表了一篇论文,并验证了这一原理。它并非由ChatGPT虚构,而是真实存在的理论。根据该理论,在此背景下,处理信息所需的能量(或最小能量),其下限为KB×T×ΔH,其中KB代表玻尔兹曼常数,T为环境温度,而ΔH是熵值,具体地说,是互信息熵。这是一项极具影响力的理论成果。尽管有人质疑其正确性,但学界普遍认为它能够成立。
那么接下来,我向学生提出的问题是:基于这些背景,我想了解当前AI和区块链系统的发展现状。于是,我让学生们去做这项研究 —— 作为教授,你确实总能让学生来承担工作,而自己则站在聚光灯下展示成果。这也就是为什么人人都想当教授,而不是做埋头苦干的可怜博士生。
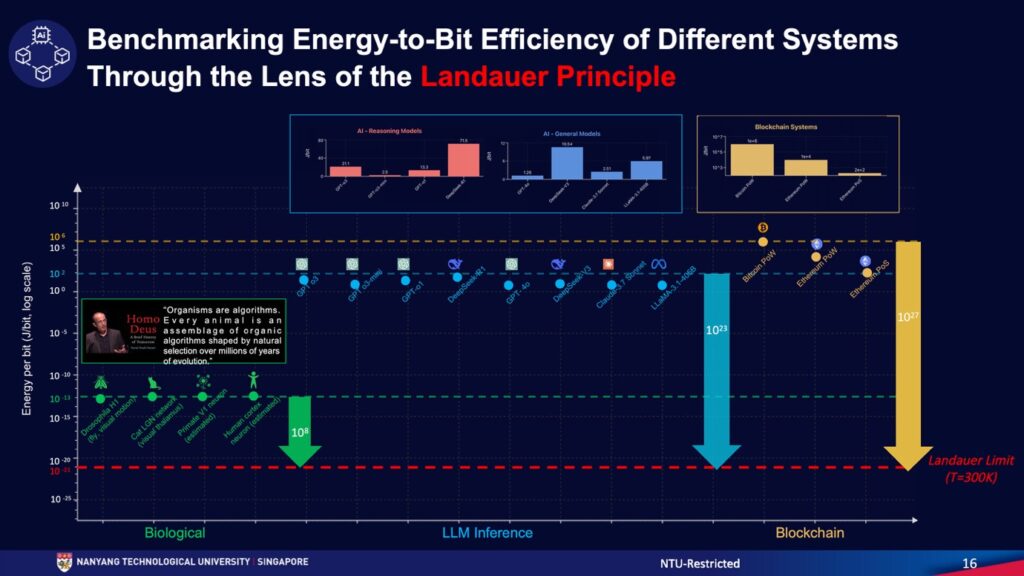
因此,我想探究的是:当前,我们的系统距兰道尔原理的基本极限有多远?在探讨区块链或AI系统之前,人们总是宣称,还有另一个更为优越的体系—— 它被视为世界上最重要的系统,那就是生物系统。人们常说 ChatGPT 能比人类表现得更为出色,但我们也普遍认为,人类大脑才是最高效节能的,我想知道这种说法是否属实。于是我告诉学生们:去查阅生物学领域的研究论文,弄清楚这些生物系统的能量效率或能耗数据。
此外,我最近在读尤瓦尔・赫拉利(Yuval Noah Harari)的著作《未来简史》(Homo Deus:A Brief History of Tomorrow)。他提出了一个观点(尽管我对此持保留态度) :有机体本质上是算法。每一种动物,都是在数百万年间由自然选择塑造而成的有机算法集合体。他提出,所有的生物过程本质上都是算法。而这些算法是经过数百万年历史的自然选择,由自然演化而成的。因此,我想探究这些生物系统的能量效率究竟如何。
我们研究了各种生物系统——说实话,我甚至不会念这些生物学里的名称,但还是能看懂人类大脑皮质数据的。所以,暂且假设我们都了解这些不同类型、不同层级的生物系统,粗略来看,其能量效率约为 10⁻¹³ 焦耳 / 比特,而兰道尔原理的极限值是 10⁻²¹ 焦耳 / 比特。
首先,从生物系统的能耗到兰道尔极限,其间存在着 8 个数量级的巨大差距。其次,我想知道,对于AI系统而言,它们在能耗方面的表现如何。于是我让学生们研读大量文献,试图总结出AI推理模型与生成模型的能效水平。我们查看了所有顶尖模型的数据,其能耗约为 10² 或 100 焦耳 / 比特。不难发现,它与兰道尔极限之间存在 23 个数量级的巨大差距 —— 这正是我们优化系统的空间所在。
再看区块链系统,其每比特能耗约为 10⁶ 焦耳 / 比特,与兰道尔极限相差约 27 个数量级。这意味着,科研人员开发的这两大系统(AI与区块链),在能效上远不及自然演化出的生物 —— 无论是动物还是人类。
因此,这种差距为我们这样的研究者提供了一个不错的研究领域:优化AI和区块链这类人造系统的能效。根据《未来简史》一书的观点,尽管上帝持续使动物系统得到进化,祂并非这条道路上唯一的行者。如今,进化还需依靠这些经历自然选择后形成的系统,以及人类设计的力量。
核心问题在于,我们能在多大程度上提升能量效率,又有哪些值得进行创新的领域?我曾看到一篇未来学研究者的博文,其中提到:为实现能量效率优化,有三个创新回路需要被构建:软件、硬件和制造技术。在软件层面,他指出,其能效的提升空间高达 13 个数量级。
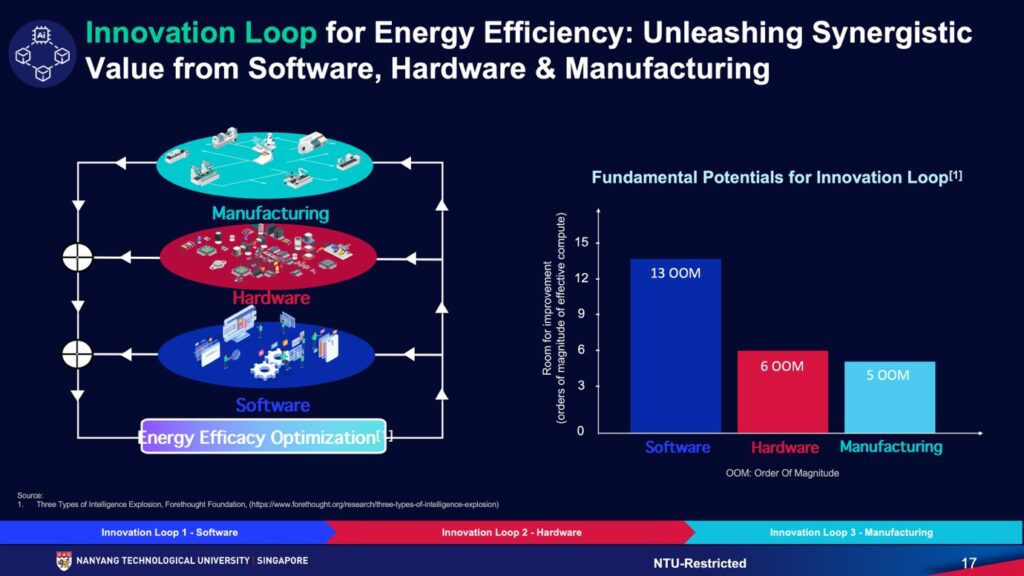
在硬件层面,据他估算,优化空间可达六个数量级。而在制造技术或芯片设计领域,则存在五个数量级的提升潜力。若我们把这三个层面的数据相叠加,将可能实现二十四个数量级的能效提升。理论上讲,如此大幅度的提升是有机会实现的。别忘了,在能耗上,顶尖模型与极限值的差距只有23个数量级。因此他提出,从数量级尺度上看,技术发展或许能让系统能耗无限接近兰道尔极限,甚至比后者还低一个数量级。这其实已经很令人惊叹了。
就当我以为结论会自相矛盾、让自己陷入困境时,结果却发现,粗略地看,这个数值基本合理——顶尖模型和兰道尔极限的差距确实是22或23个数量级,对区块链系统而言,差距则为27个数量级。
上述内容在这套逻辑下奇妙地自洽了,所以当我得出这一结论时,心里其实格外欣喜。这是该框架带来的第一层启示。
第二层启示来自我过去在代币与通信理论领域的研究。我试图提出代币容量定理(token capacity theorem)这一概念。大家还记得这个框架吧?就是我们反复提及的:输入、算法、输出。
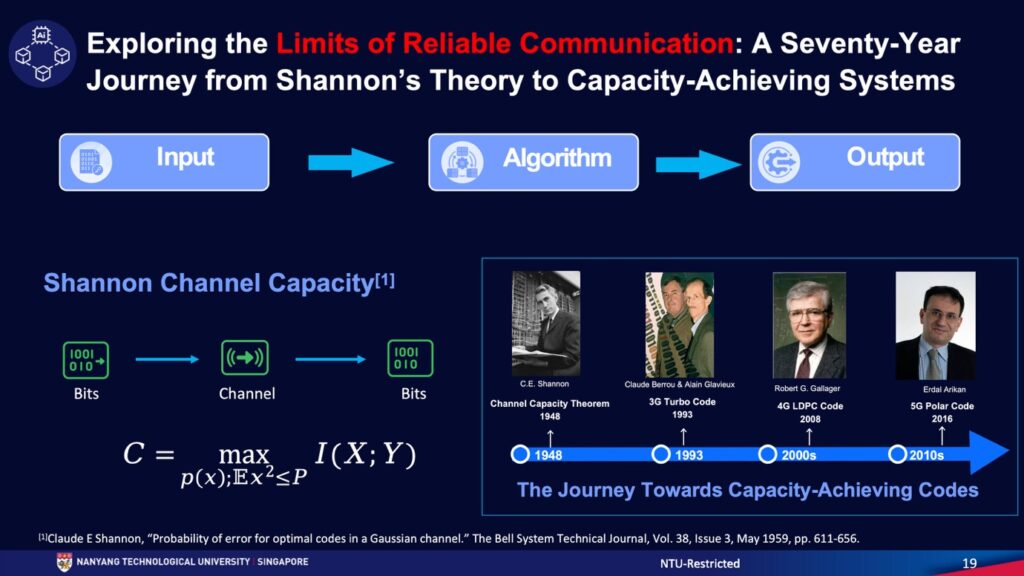
对熟悉电气工程或信息论的同仁而言,我们时常使用香农信道容量定理(Shannon channel capacity theorem),它同样由克劳德・香农(Claude Shannon)提出 ,发表于 1959 年,同样源自IBM和贝尔实验室。这足以说明,上世纪五六十年代堪称现代工程科学的黄金时期。研究团队关注通过信道传输与输出的比特,而该信道所能传输的比特总量,会受到信道容量的限制。这一理论并不是凭空诞生的,在1948 年,香农率先将它提出,信道容量的概念也自此确立。
而后在1993年,涡轮码(Turbo Code)被提出,其目的是找到一种逼近该容量的方法。而事实上,早在 1956 年,香农的学生罗伯特·加拉格尔(Robert G. Gallager)的博士论文就已经围绕低密度奇偶校验码(LDPC Code)展开研究。只是该码的构造在当时还过于复杂,没人能证明它是否具备逼近信道容量的可行性。
但到了2000 年,学界终于证实,LDPC 码是一种可逼近信道容量的编码方案。2010 年,土耳其的阿里坎(Erdal Arikan)教授研发出了极化码(Polar code),他是加拉格尔的博士生。极化码真正实现了对信道容量的理论逼近,确保通过信道传输的信息总量能达到理论最大值。
巧的是,我其实跟这些学者毕业于同一间实验室,即麻省理工学院的信息与分布式系统实验室,和阿利坎也有过几次见面。当时,我尝试在博士论文中解决一个棘手的难题,正处于一筹莫展之际。后来有一天,我找罗伯特・加拉格尔聊了聊,对他说:“我请您喝杯咖啡,能否为问题的解决指点一二?”这篇论文研究的课题,名叫“基于图像的群组检测”(group testing over graph)。
也许大家对此并不了解,群组检测的原理,其实在新冠疫情期间就有实际应用:要检测一个群体中是否有人感染病毒,不必对每个人单独排查,只需将所有样本混合,进行一次检测即可。若结果呈阳性,就说明人群中存在感染者;若是阴性,则全员通过。所以问题在于,如何用最少的检测次数,来确定每个人是否感染了新冠病毒,而LDPC码正是这一问题的最优解。
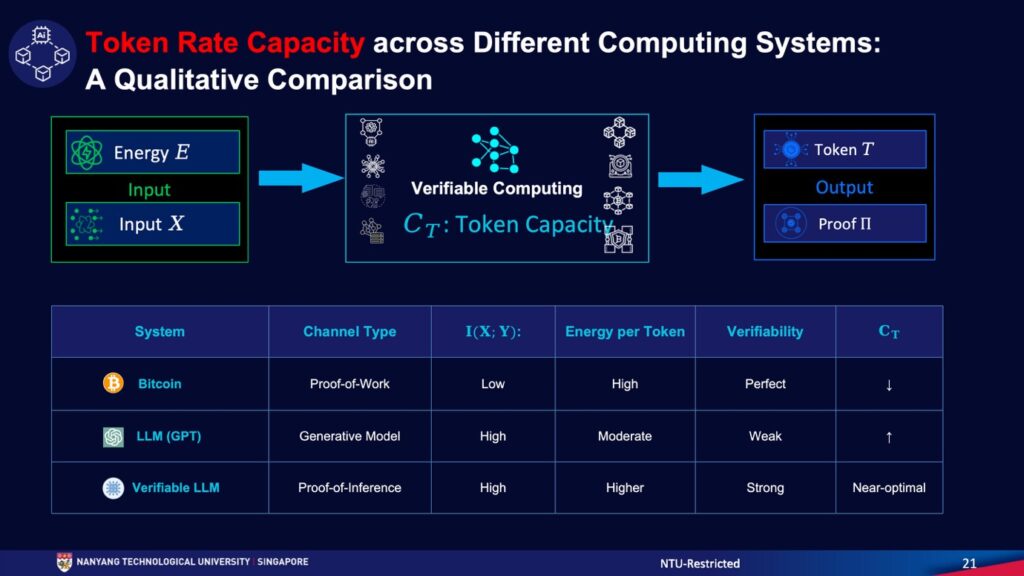
短短五分钟内,他就为我的博士课题给出了解决方案,基于该思路,我完成了整篇论文的写作。现在,如果我们沿用上述视角,就能够来考察这个通用架构:其核心是信道,如今它实际承载着计算与比对的功能;系统的输入是能量和信息,输出则为代币,同时我们要求这一输出具备可验证性、能够被证明。
以下是通信系统与可验证计算系统之间的对比:通信系统的输入为比特,信道则对应自然物理现象。无论引入噪声、存在多径效应,还是增加其他干扰,比特仍然是最后的输出。而在可验证计算系统中,输入的要素则是能量/提示或谜题,
它的信道由人工算法构成,输出则包含代币和相应的证明。我十分欣赏这种在不同系统间建立知识关联的思路——也许数学是唯一能贯通这些问题的科学,或是人类解决这类难题的本质需要。倘若这个类比成立,我们便可以仿照相同路径,去推证出代币容量定理。
这是我刚刚构思出的一个博士研究课题。如果有朋友想在该方面开展博士阶段的研究,或者您身边有人愿意接受这个挑战,欢迎来联系我——我备有专项奖学金,可用于支持从事这项研究的博士生。
如此一来,当我们考察这些不同的系统时,以比特币为例,其工作量证明机制便可被视为一种信道类型。我认为这项研究的要点在于:代币的能耗水平高,而可验证性低。通过该视角,我们能对所有相关系统展开对比分析,这是我从AI和区块链系统的结构相似性中总结出的两点结论。现在,假设我刚才所阐述的这些内容能够成立,接下来该如何推进,有哪些工作可以在这方面展开呢?我梳理出了两个研究方向,将它们称为“AI与区块链间的共生”。第一个方向是水到渠成的: 将AI技术应用于区块链领域。
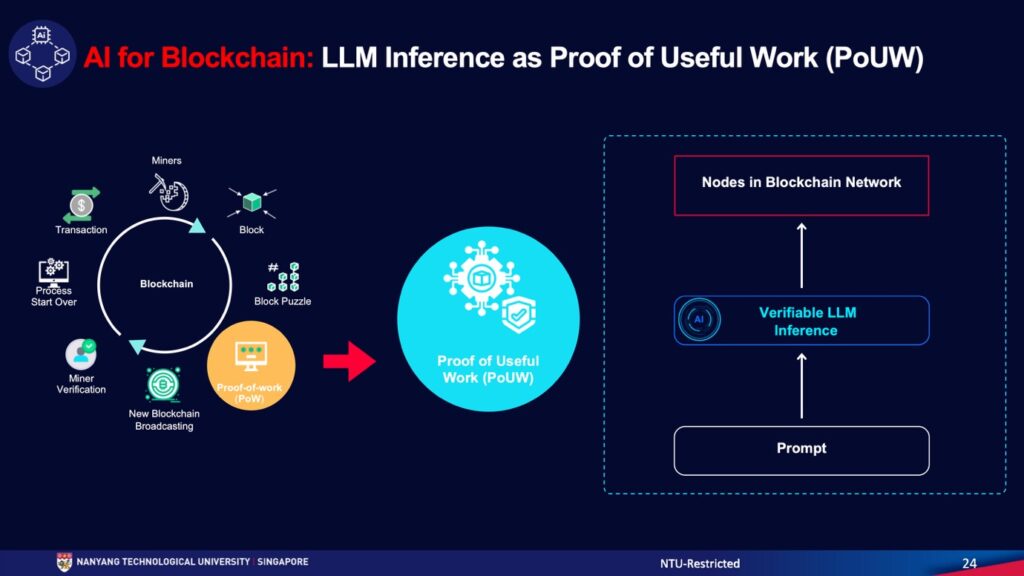
与其让加密货币挖矿者做无意义的哈希计算,我们能否将可验证的大语言模型推理(verifiable large-language model inference ),作为有实际价值的工作量(workload)呢?也就是我所说的,把有用工作量证明(Proof of Useful Work)引入加密货币挖矿中。这便是第一个研究方向,实际上,它并非由我首创,也不是全新的构想。在区块链研究领域,已有学者探索如何将可验证的大语言模型作为去中心化的共识机制;在技术研究界,人们对相关论文展开了诸多讨论;对实际项目而言,从业者也尝试把该思路应用到实践中,这是一种顺理成章的做法。
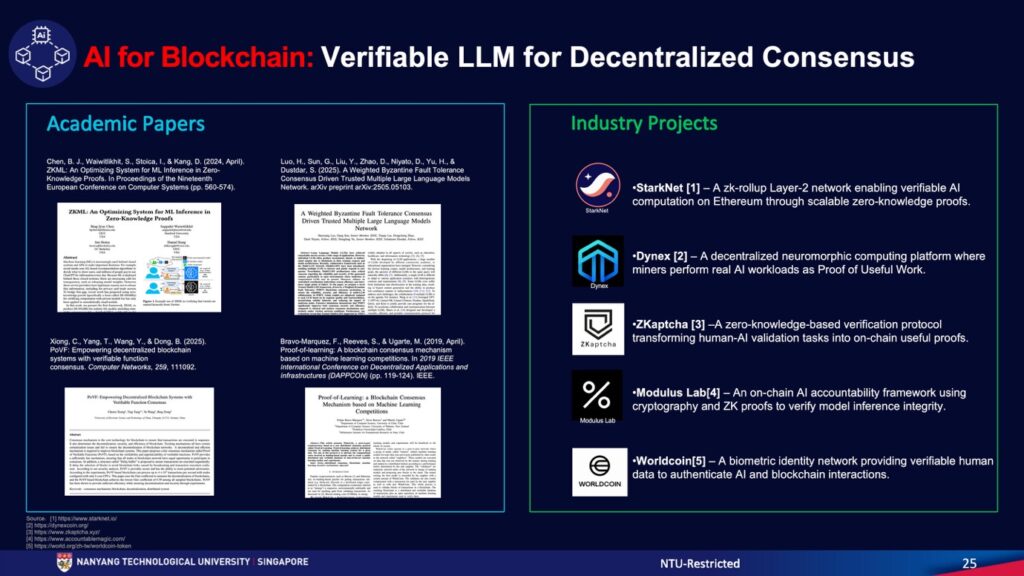
当然,要使它真正落地,还有大量优化工作需要开展,对“零知识证明的大语言模型”(ZK-LLM,Zero Knowledge Proofs for Large Language Models)[2]而言尤其如此。就在前几天,我刚和维塔利克讨论过这个问题。目前的研究状况会延续至未来吗?答案是否定的,在将来,会有专门适配这一需求的芯片出现。
第二个方向是:将区块链技术用于到AI领域。因为当前,AI业界呈现出高度中心化的特征——无论OpenAI、Anthropic还是其他机构,其模型都或多或少地体现了公司控制者的理念,特别是在价值对齐层面。这些机构各自有其世界观,他们将自身的观念嵌入了模型之中,但这并非我们所期望的。在我看来,AI模型或许应当具备“中立的独立性”(neutral independence)。因此,有可能借助区块链技术,把它作为底层大模型推理与训练过程的核心赋能者,从而构建出相应的解决方案。但毫无疑问的是,要实现这一目标,我们还有很长一段路要走。
上述思路只是初步的构想,人们可围绕该目标开展AI与区块链的融合研究。需要再次说明的是,这个观点并非由我原创。事实上,已有学术研究与行业实践者在沿着这个方向探索,致力于用ZK-LLM/可信执行环境来实现可验证的大模型推理。同样,对爱好该领域的研究者而言,这也是潜在的博士课题。
以上内容是我在尝试回答“当AI遇见区块链,将会发生什么?”这个问题时,所经历的一番思想推演。其核心初衷是,我试图为这一领域提供一些新的视角,也希望能为我的博士生发展出若干新的研究课题。因此,我将可验证计算视作一个统一的研究基底——把它称之为“统一”,旨在实现AI与区块链之间的融合,这正是我为该课题招募博士生的初衷。如果各位对此感兴趣,欢迎随时与我联系。
在演讲即将结束之际,我想简单做个宣传,希望飞达教授不会介意这一点。我想介绍自己在南洋理工大学的研究中心,它的名称是南洋理工大学计算金融研究中心(NTU Centre in Computational Technologies for Finance)。我们是推动区块链研究与教育发展的顶尖研究中心,开设了区块链理学硕士项目,这也是全球首个由 QS 前 30 高校设立的区块链硕士学位。
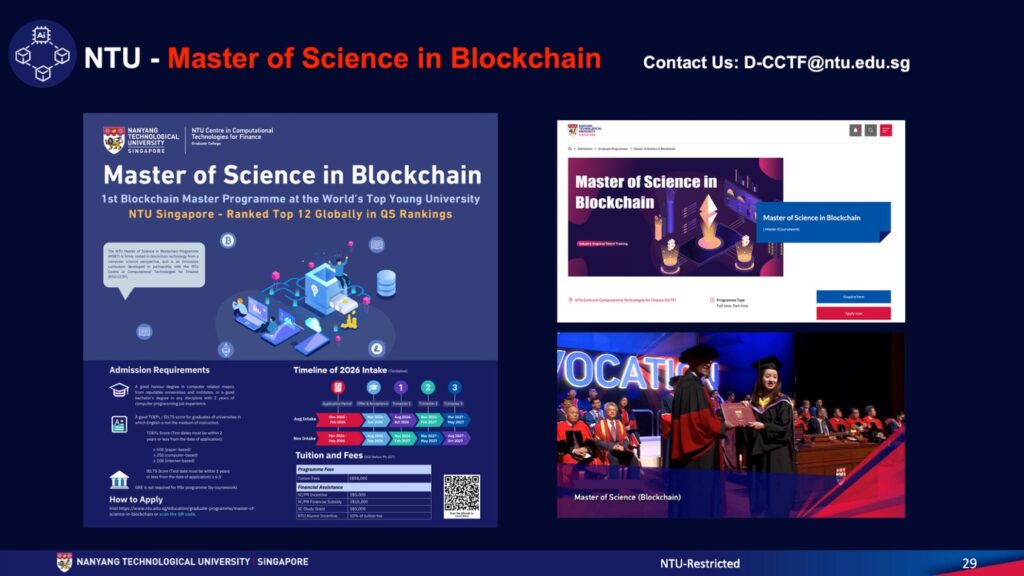
此处的”首个”需要加上引号,因为有另一所大学比我校早一年开设了区块链硕士项目,即香港理工大学。香港在这方面的行动确实比新加坡快上不少。同时,我们去年还设立了区块链博士学位,这是全球首个获得政府官方批准的区块链博士项目。因此,如果您有兴趣攻读我们的区块链硕士或博士学位,欢迎随时与我联系。
这是首届学生毕业时的合影。照片里这位可能是新加坡总统。不对,应该是驻阿联酋大使吧?我的分享就到这里,接下来是提问时间,如果大家有兴趣的话。
现场提问
Q:我们认识很长时间了,但今天还是第一次听您谈论“AI和区块链融合”这个有趣的话题。我想问的是,在学术圈里,人们对这两个领域做了许多研究,当我们谈论这种融合时,在您看来,二者间的联系会对私人领域(如AI和区块链的应用)产生什么影响呢?
A:这是一个很好的问题。我这么做的目的,是帮助学生们开发一个能将二者统一起来的最优框架,他们研究的内容,正是这两个系统的优化,尤其聚焦于能效上的提升。因为我的研究方向是可持续计算(sustainable computing)与能效提升,所以希望将自己和学生的研究对象纳入同一个原理和框架之下,让它们实现能效最优的目标。
我需要厘清问题所在,明确当前研究和兰道尔极限之间的差距。这实际上能为学生提供研究方向上的指引,而非直接规定他们必须走某条路,只需为他们提供思路即可。
Q:谢谢,能源确实是当下和未来最核心的问题,让我们再次感谢演讲者。
A:谢谢。
注释
[1] 四种基本力:引力、电磁相互作用力、弱相互作用力、强相互作用力
[2] 零知识证明的大语言模型(Zero‑Knowledge Large Language Model,zkLLM):指融合了零知识证明技术的大语言模型。零知识证明是一种密码学方法,允许一方(证明者)向另一方(验证者)证明某个计算或陈述是正确的,而无需透露除“该陈述为真”之外的任何额外信息。ZkLLM 能在不暴露模型参数、用户输入以及推理过程的条件下,生成一个可被验证的证明,使任何人都能确信,模型的输出确实是由指定模型经过正确计算得出的,从而实现隐私保护推理。这一技术常用于去中心化AI、链上智能合约验证等需要确保计算完整性与数据隐私的场景。
讲者介绍
文勇刚
文勇刚博士现任新加坡南洋理工大学副教务长(研究生教育)及研究生院院长、计算机科学与工程学院校长(讲席)教授,新加坡工程院院士、IEEE会士、ACM杰出科学家。他深耕云计算、绿色数据中心、区块链及机器学习等领域,发表顶级期刊与会议论文300余篇,并多次获IEEE等国际顶级期刊与会议最佳论文奖。
近年来,其领衔的“数据中心认知数字孪生”研究屡获殊荣,包括2015年数据中心动力学-亚太地区奖、2016年东盟信息通信技术金奖、2020年IEEE TCCPS工业技术卓越奖、2021年W.Media亚太云和数据中心技术领袖奖及2022年新加坡计算机协会数字杰出科技领袖奖,致力于推动数据中心数字化转型与环境可持续发展。